2025年の振り返りと2026年の目標
あけましておめでとうございます。
明日から仕事ということで、そろそろ重い腰を上げて振り返りと今年の目標を立てようかと思います。
仕事
2025年は、リードする案件、自身で手を動かす案件、どっちも経験した1年でした。
あとは、とにかく出張が多くて大変でした。飛行機の狭い空間で資料作ったり、ホテルで深夜まで資料作ったり… まぁこれは今も継続していますが、最初は大変だった。
特に9-11月は新しい案件が始まったのもあって、しんどかった。けど、何とか乗り切りました。
公開できるアウトプット系で言うと、2年くらいかけた書籍を出すことができました。
AWSサービスを使った実践的なデタマネ本ということで、特定の人にはかなり刺さるテーマの本が書けたと思います。
あとは、本ってこういう風に作られるのかーというのもわかって面白かったです。
また、MWAAのBlackbeltの資料も公開できました。MWAA関連は、2025年にv3対応、サーバーレス対応もしてなかなか熱いので、2026年も触れていきたいと思ってます。
https://pages.awscloud.com/rs/112-TZM-766/images/AWS-Black-Belt_2025_Amazon-Managed-Workflows-for-Apache-Airflow_0331_v1.pdf
プライベート
健康
平均して週1-2回はジムに行けたので、これはなかなか健康的だったのではないでしょうか。
あとは月1回のスカッシュも継続できたのも良かった。これは2026年も続けていきたいですね。
趣味
今年は、そこまでライブに行けなかった。。
ももクロは5,6回?それ以外はポルノ1回、榊原ゆい1回、パトラちゃんファンミ1回くらいですかね。
ももクロはベースで行くとして、それ以外も今年は少しずつ増やしたいです。
旅行は、秋に大阪(ユニバ)に行きました。
途中からめちゃくちゃ雨降ってきて、ジェットコースターに乗れずじまいだったのが残念でした。
ただ、JTBラウンジは神ということが分かったので次行くときもこれは付けたいですね。14時くらいにクッソ空いてるラウンジで休めるの最高です。
メイプルストーリーは8月くらいで忙しくなってやらなくなってしまいました。
ただ、7月にずーーーーっと買うか悩んでいたパンダ魂付き200武器を35000円で買ったことは覚えています。
もはや強さとかいうよりも、高級インテリア的な感じの満足感ですね。
生活
今年、ついにマンションの一室を買ったり買わなかったりしました。
そしてついに!ドラム式洗濯機を購入しました。これは完全に2025年マストバイ商品でしたね。
毎朝干していた20分が完全になくなりました。超最高。
2026年の目標
- 生成AIについて頑張って勉強する。できればアウトプットを出す。
- 何か、仕事で、事を成す。
- ジムに週1で通う。
- ライブにたくさんいく。
こんな感じですかね。
今年も、そこそこ頑張っていきましょう!
論理的な説明には度胸と粘り強さが必要ではないか
こんにちは。久しぶりの記事です。
風呂に入りながら、考えたことがあったので記録します。
論理的に説明するとはどういうことか
「論理的にものごとを考えられるようになりたい!」こう思ったことがある人は多いと思います。
本屋にも、論理的思考力の本がたくさん置いてありますよね。「小学校に上がるための本」はないことからも、本屋にたくさん置いてあるテーマはみんながなりたいようなテーマであることが分かります。
さて、この「論理的に説明する」というのは、テクニックとか頭の良さが必要という印象がありますが、私は「粘り強さ」と「度胸」が必要だと思ってます。
そもそも論理的に説明するってどういうことかをまず考えていきます。
正確な定義などは調べていないですが、論理的とは、なにかの主張の理由が述べられているということだと思います。
例えば、ChatGPTに「貯金だけでは資産は増えない。投資が必要である。」という主張を論理的に3行で説明してもらいました。
貯金はインフレにより実質的な価値が目減りする。
投資はリスクがあるが、長期的にはインフレを上回るリターンが期待できる。
よって、資産を増やすには貯金だけでなく投資も必要である。
このように、ある主張に対して「なぜそうなのか?」を考えていくことが論理的な思考だと言えます。
そう考えると、これってあんまり難しくないですよね。日々の生活でも、なにかをするときは理由があるはずです。
折り畳み傘を持つのは雨が降りそうだから。新品のシャツで会社に行くのは、今日がキックオフの日だから。詰め替え洗剤を買うのは、そろそろなくなりそうだから。
これと同じように普通に考えれば、論理的な思考になります。
そもそも、論理的に説明したものというのは、誰が見てもその理由が明確になっているはずです。先ほどのChatGPTの例も、具体的な金融知識の話は置いておいて、主張は理解できます。
つまり、論理的な説明に、難解な学術知識などは不要なのです。みんなが分かる言葉や知識で説明できないと、それはいわゆる論理的な説明として認識されません。
なぜ論理的な説明ができないのか
では、簡単なことなのに、なぜみんな論理的な説明ができないと思っているのでしょうか。
それは、実際に仕事で何かを進めるときに主張をすることを考えると分かります。
例えば、転職した会社である商品を開発するプロジェクトに新しく入ったとします。でも、前までの経験から、そのような商品はおそらく売れないだろうと考えたとしましょう。
この時、その商品が売れない理由を考えるのは、普通にできるはずです。前職での経験や、そこで起きたことから説明ができるからです。そもそも「売れない」と思ったのは何か理由があります。
考えるのはできる。ただ、それを周りの人に言って、納得させるのが難しいんですよね。
新しく入ってきた人が何か言っても、「はいはい、よそではそうだったかもしれないけど、ウチは特殊な事情があって…」と聞いてもらえません。
もし聞いてもらったとしても、今動かしているプロジェクトを変えるのは相当困難です。今のプロジェクトにGoサインを出した人の判断が間違っていたと認めることになります。
また、確かにその人は「売れない」と考えたとしても、何か別の事象が相まって売れるかもしれません。絶対に売れない保証はどこにもありません。
これらの理由から、論理的に説明することができなくなってしまうのです。もう少し細かく言うと、論理的に考えることはできるが、その主張を周りに行って納得させることができないのです。
論理的な説明には何が必要か
ということで、これができる人とはどういう人なのか?とタイトルに戻ってきます。
それは、度胸があって、粘り強い人です。
まず、論理的な考えを、声に出して周りに伝える必要があります。これをしないと、絵に描いた餅ですが、これがまぁ結構大変です。度胸がいります。
そもそも人間は、変わらないことが心地よい生き物です。変わるには大きなエネルギーが必要で、それが大きなプロジェクトを変えようとする第一声となればとてつもなく大きなエネルギーが必要となります。
次に、それを伝えたとして、周りからの質問に答えたり、出てくるNGに対応していったりする必要があります。おそらく途中であきらめたくなるはずですが、粘り強く対応していかなければなりません。
Noと言えない日本人という本がありましたが、日本人は特にNoというのが苦手らしいです(ちなみに私も苦手)。こちらの主張に対するストップの声に対して、Noをずっと言い続けなければならない。これは非常にタフネスが必要ですよね。
ということで、結論、論理的思考力には度胸と粘り強さが必要、と考えました。
新人の方々は、まずマザー牧場のバンジージャンプに行って、その後真っ白なジグソーパズルを組み立ててみるとよいのではないでしょうか。
【感想】基礎からの新しいストレージ入門
皆さんは、ストレージを使っているでしょうか。私は、パソコンに入っているSSDやHDD、NAS、Google DriveやDropboxなど様々なストレージを利用しています。ただ、そこにどんな技術が使われているかはあまり意識したことがなく、興味を持ったのでこの本を購入してみました。
結果、ややハード寄りですが、ソフトとハードをうまいこと組み合わせて使っていることが分かって面白かったです。その中で、重要と感じたポイントや、少し詳細に調べてみたことを記録しておこうと思います。

目次
どんな本?
2023年8月に発売された、ストレージの仕組みを解説している本です。ブロックストレージ、ファイルストレージ、オブジェクトストレージ全て記載されていますが、メインはブロックストレージです。また、仕組みだけでなく著者の経験によるベストプラクティスや、最近のストレージのCloud Native化についても言及されておりためになります。ストレージの種類やプロトコルについて、なんとなく単語レベルで聞いたことがあるくらいの認識でしたが、この本で体系的に整理できてとても良かったです。
重要と感じたポイント
全体の中で、chapter1, 2のストレージの仕組み、chapter5のベストプラクティスの部分が個人的に特に参考になったと感じたので、その中から重要そうなポイントをピックアップしてみました。
接続インターフェース(マザーボードとドライブ間)
接続インターフェースの代表例としてSAS、SATA、NVMeが紹介されています。SAS/SATAはHDDと共に進化してきたインターフェースであり、NVMeはSSDの登場に伴い登場したインターフェースとのことでした。ちなみに、SASはSCSI(スカジー)系のインターフェース、SATAはATA(アタ)系のインターフェースらしいです。
このインターフェースの規格については、まさに「名前は聞いたことあるけど体系的に知らない」知識の代表でした。SATAケーブルなどをよくわからずつないだことがありましたが、HDDのインターフェースの名前だったんだなと腑に落ちました。
これについては、もう少し調査して内容整理したので後述します。
接続インターフェース(サーバーとストレージ間)
こちらは、PC内のマザーボードとドライブ間の話ではなく、サーバーとストレージ間の話です。いわゆる外付けのストレージ接続ですね。こちらで使われる通信にはデータ自体の読み書きを行う処理のデータプレーンと、ボリューム作成/削除などメタ的な操作を行うコントロールプレーンの2つがあります。
ブロックストレージ向けのデータプレーンのプロトコルとして、FCP(Fibre Channel Protocol)、iSCSI、NVMe-oF(NVMe over Fablics)の3つが紹介されています。FCP/iSCSIは、SCSIの命令セットをネットワーク上で使用できるプロトコルです。前者のFCPは光ファイバーケーブルの専用ネットワークを使い、後者のiSCSIはTCP/IPのネットワークで使えるところが違いです。iSCSIの方が、現在よく使われるネットワークで使えるので、安価に使えます。
よく考えると内蔵ディスクと外付けディスクでは通信プロトコルが違うのは当たり前ですが、意識したことのない差でした。そしてそれが内蔵ディスクの方のプロトコルをネットワーク上で使えるように拡張したものであるというのも、面白いポイントでした。
RAIDとミラーリング
ディスクの冗長化の方法であるRAID(RAID0/RAID1/RAID1+0/RAID5)と、ストレージの冗長化の方法であるミラーリングが紹介されています。RAIDはハードディスクなどのドライブ障害の対策であり、ミラーリングはストレージ自体の個体障害、データセンターなどのサイト障害の対策になります。この時、サイト障害対策のミラーリングは長距離となるので、ミラーは非同期になります。
RAID、基本情報を受けるときに覚えて、それ以降はあやふやなままでした。冗長化のうちの1つの手法である、と捉えると理解が進みますね。また、考え方は分散処理に出てくるレプリケーションとパーティションと似ている概念ですよね。このあたりは、分野が異なっても概念というか考え方は共通していて、面白いです。
スループットとIOPS
性能監視の際の指標値として、単位時間当たりのデータ転送量であるスループットと、1秒間に読み書きできる回数のIOPS(Input/Output Per Second)が紹介されています。前者はデータの転送量、後者は読み書き回数に着目した性能の指標値です。ワークロードによって、重視するものは異なります。
AWSのブロックストレージサービスであるEBSにも、Provisioned IOPS SSDボリュームと、スループット最適化 HDDボリュームが存在しています。この違いがより理解できました。
接続インターフェースについてもう少し調べてみた
SAS、SATA、NVMeなどの接続インターフェースについて、もう少し調べてみて自分なりにまとめてみました。 SSDのインターフェースと、HDDのインターフェースで分けて記載します。
SSDのインターフェース
この書籍と、いくつかのWebサイトを見てオリジナルでまとめたのが以下の図です。オリジナルの図なので、もし誤りがあった場合はご指摘いただけると助かります。
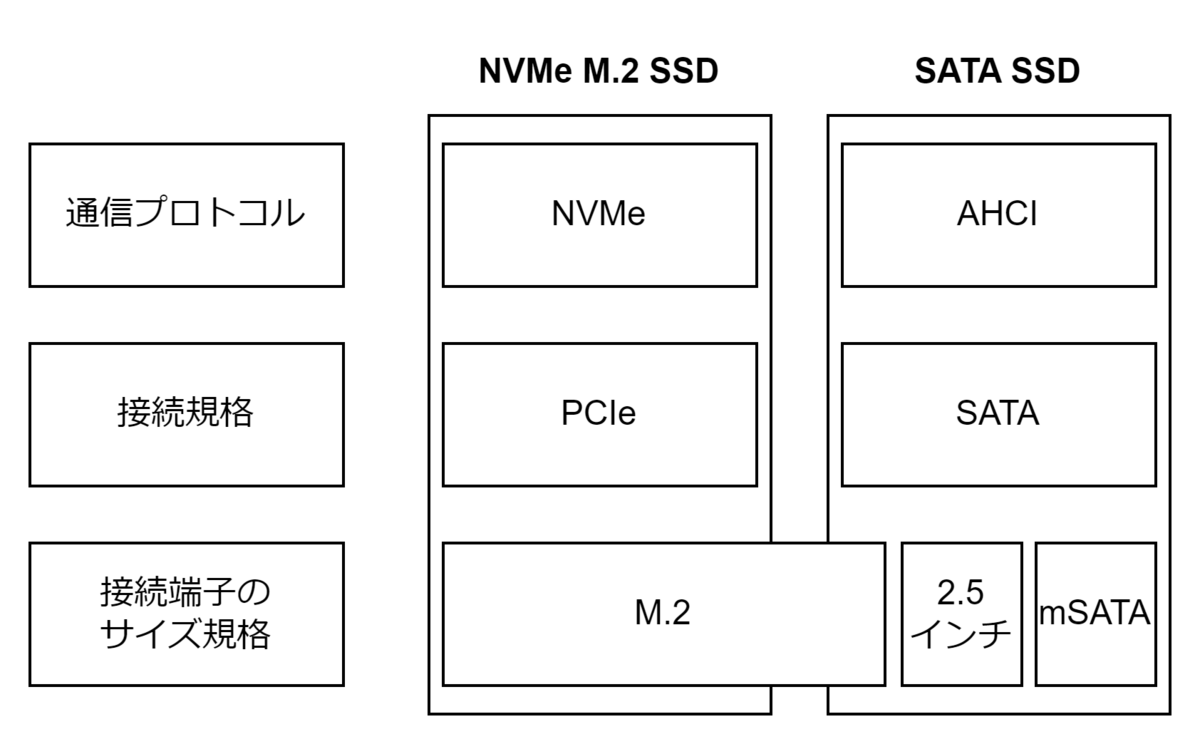
書籍に出ていたように、SSDのインターフェースはNVMeとSATAが代表的な2つです。ただ、調べてみると、それぞれ通信プロトコル、接続規格、接続端子のサイズ規格というレイヤーの異なる規格に分かれているようです。そして、NVMeとPCIe、AHCIとSATAはセットのようですが、接続端子のサイズ規格はいくつか種類に分けられるようです。
参考に、価格.comのSSD製品一覧で、それぞれの対応SSDの個数を調べてみました(2024年1月15日時点)。
| サイズ規格 \ 接続規格 | PCIe | SATA |
|---|---|---|
| M.2 | 572 件 | 110 件 |
| 2.5 インチ | 37 件 | 357 件 |
| mSATA | 0 件 | 40 件 |
PCIeはM.2、SATAは2.5インチが多いですね。ただ、PCIeの2.5インチや、SATAのM.2もあることはあるようです(PCIeの2.5インチについては、数が少なかったので上図では省略しています)。M.2だから速い!と思って買うのではなく、ちゃんとPCIe(NVMe)対応のM.2 SSDであることまで確認した方が良いですね。
HDDのインターフェース
HDDの方は、SSDのように通信プロトコル/接続規格/接続端子のサイズ規格のレイヤーに分かれた説明がネットでもありませんでした。あったのはインターフェースとしての歴史的な経緯で、以下の2つの系譜です。
ATA (IDE) となっているのは、実質同じものを指しているからです。IDEという規格を、ANSIがATAという規格に標準化したとのことでした。
SASはSATAより高速らしいですが、おそらく私が買ったことあるPCに入っているのはすべてSATAだったと思います。SATAとSASでは端子から異なるので(SCSIとATAも異なりますが)、ぜひ秋葉原かどこかで実物を見たいですね。
こんなにある!HDDの種類 – バックアップ・データ復旧 | GUARDIAN+R
EC2+EBSの接続を確認してみた
さて、ここまでいろいろ調べると、実際にやってみたくなるのが人のサガ。書籍では記載がありませんでしたが、AWSのサービスEC2+EBSでどのようなインターフェースで接続されているのかを確認してみます。
EC2インスタンスにEBSをアタッチした後に、EC2インスタンス上でフォーマットとマウントを実行します。こちらは、書籍に記載のコマンドと大体同じでした。ただ、書籍ではiSCSIのプロトコル(コマンド)を使用してアタッチしていましたが、EC2+EBSではコンソールかAWS CLIでアタッチするのでどのインターフェースで接続されているのかがよくわかりません。
そこで、PCIデバイスの情報を表示する lspci コマンドを実行してみます。すると、以下のように表示されました。
sh-4.2$ lspci -nn | grep memory
00:04.0 Non-Volatile memory controller [0108]: Amazon.com, Inc. Device [1d0f:8061]
00:1f.0 Non-Volatile memory controller [0108]: Amazon.com, Inc. Device [1d0f:8061]
この最後のカッコ[ ]の後半4桁がDevice IDを表すらしく、8061はNVMe EBS Controllerを表すそうです。つまり、プロトコルとしてNVMeを利用していることが分かりますね。
EC2から見るとマザーボードとドライブ間のインターフェースであるNVMeとして認識されていそうですが、よく考えてみるとEC2とEBSは直接物理的につながっているわけではなくネットワークを通してつながっているはずです。EBSのBlackBeltを見ると、やはり実体はネットワーク接続型ストレージのようですが、ユーザはネットワークを意識する必要はないそうです。
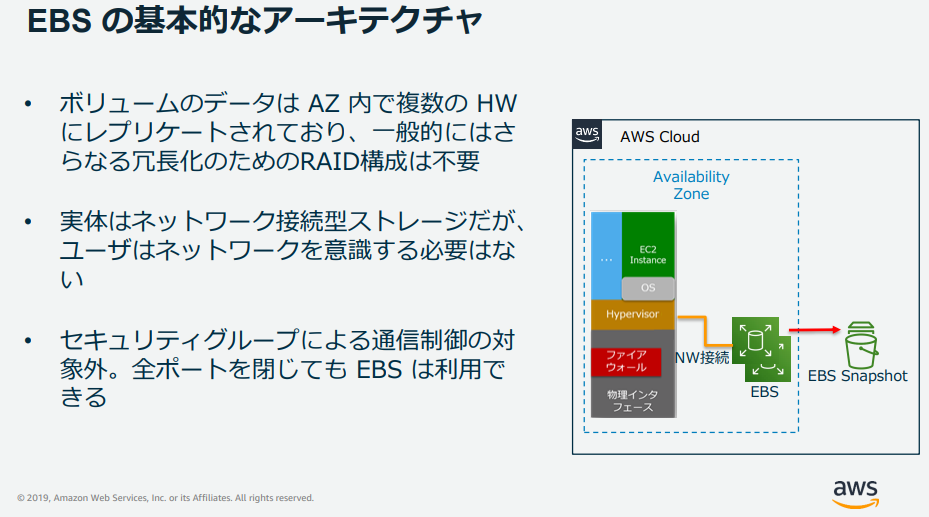
https://d1.awsstatic.com/webinars/jp/pdf/services/20190320_AWS-BlackBelt-EBS.pdf p.12より
おわりに
この書籍をきっかけに、ストレージについて興味を持って調べることができました。何気なく使っているストレージですが、中身の仕組みを調べだすととても面白いですね。クラウドサービスでも、ストレージのどの種類なのか、どのプロトコルが使えるのかなど意識してみてみると、より理解が深まりそうだなと思いました。ストレージやネットワークなど、基礎知識をしっかり学習するのは重要ですね。
参考
記事内に張ったリンク以外に、参考にしたページを載せておきます。
・Dell Technologies の方のインフラ基礎のスライド資料
https://japancatalog.dell.com/c/wp-content/uploads/20221021_beginners.pdf
【感想】世界一流エンジニアの思考法
あけましておめでとうございます。今年もよろしくお願いいたします。
今年は、知識の地盤を固める年にしようと思いまして、その一環として積読を消費していこうと思っております。
その第一弾として、この本を読んだので記録しておきます。

目次
どんな本?
2023年10月に発売された、米マイクロソフトの現役エンジニアの方(日本人)が書いている本です。Azureの開発に関わっている方で、アメリカのマイクロソフトで働くようになってから気づいたこと、周りの凄腕エンジニアがやっていることなどを分かりやすく解説してくれています。Amazonでは★4.7でめちゃくちゃ人気の本です。
内容を一言でいうと、色々な無駄なことをやめれば仕事の生産性高まるぜ!空いた時間で筋トレして幸せになろう! という感じでしょうか。この「無駄なことをやめれば」というところの考え方が、色々と載っていて面白いです。ここからは、個人的に気になったポイントをピックアップしていきます。
気になったポイント
一つだけピックアップする
生産性を高めるための考え方の一つとして、「Be Lazy」(怠惰であれ)というものが紹介されています。これは、より少ない時間で価値を最大化するという考え方とのこと。その中の一例として、この「一つだけピックアップする」ということが挙がっていました。
書籍では、エンジニアなのでバックログの中から一つだけピックアップして実装するという例が出ていましたが、なんにでも当てはめられるなと思いました。
私はとりあえずなんでも手を出したり、「あれもこれもやりまぁす!」と言って結局全部中途半端になったりということが良くあります。なので、この考え方は役に立ちそうだなと感じました。「いくつかをピックアップする」とかではなくて、「一つ」なのが良いですよね。曖昧さがない。そういう意味では、今回も書籍からピックアップする箇所は一つにしようかなと思いましたが、「一つ」選ぶことを6回やったと考えることにしました。
試行錯誤ではなく、仮説を立てる
とりあえず何でもかんでもやるのではなく、ある仮説を立ててみてそれを検証する行動をとるべし、という内容でした。書籍ではプログラムのバグを解消する際の例が載っていました。
自身のコンサルで置き換えて考えてみると、特にお客さんへのヒアリングや提案の際に使える考え方だなと思いました。ヒアリングの際は、事前情報(営業からの話や資料、会社のHPなど)から課題の原因や背景を仮定して、それを検証するようなヒアリング項目を準備する。提案の際は、ヒアリングで聞いた情報をもとに仮定を更新して、それを解決するような提案をまとめて持っていく。今思うとそういうことをしているなと思いつつ、改めて意識していきたいなと思います。
少し脱線しますが、仮説を立てるには想像力が必要であり、この「想像力」が仕事において結構大切だなと感じています。例えば仕事の見積もりをするときにも必要ですし、上記のお客さんへの提案の際にも必要になりますよね。この想像力を向上させるために、仕事だけではない様々な経験が必要になるなと思いました。
理解には時間をかける
他の章ではとにかく「時間を短縮せよ」と言っていますが、ここは逆です。どんなに天才でも理解するのには時間がかかるから、ささっと読んで分かった気になるなよ、ということです。特に「構造」を理解することが重要だと著者は言っています。プログラムやアーキテクチャの理解ではもちろん構造は重要ですが、それ以外でもまずは全体の構造を理解することは重要ですよね。
この章も、結構自分に刺さりました。最近は、あまり書籍を読み込んだり自分で手を動かしたりすることが少なくなってきていて、ブログ記事やXの内容をさらっと読んでいることが多くなっていたからです。おそらく飽きっぽいのだと思いますが、今まで業務でやってきたところは「まぁ詳しいからええやろ」と結構そのままになっているところが多いです。今年は、そのあたりも改善していかないといけないですね。
メンタルモデルを構築する
本書のp.45から引用すると
メンタルモデルとは、人々が世界を理解し、予測し、解釈し、新しい状況に適用するための、自己の心の中のイメージや理論
とのことです。さらに本書では、いくつかのフレームワークを頭に入れておいて、それに従って仕事をすることが例として挙げられていました。簡単にいうと、「仕事のカタを持っておこう」ということでしょうかね。仮説を立てる、の章で出てきた内容も、ある意味メンタルモデルの一つでしょうか。というか、それ以外の章もすべて最終的にはメンタルモデルに落としていけそうですね。
個人的には、このメンタルモデルというものをまず構築して、あとは所属している会社、お客さん、チームメンバーなどに合わせて調整していくイメージを持ちました。前職で構築したメンタルモデル(プロジェクトの進め方や資料の作り方など)を今でも大体受け継いでいますし、新しい会社のやり方を少し混ぜています。ただ、その比率(自分のメンタルモデルと、会社のやり方などの環境によるもの)は個人に依存しそうですね。私は環境に引っ張られがちなので、もう少し自身のメンタルモデルを確立しても良いかもしれません。
意見が対立しても否定しない
アメリカだと、「In my opiniton」というフレーズが頻繁に出てくるとのこと。何か否定するのではなく、「私の意見はこれなので、参考程度に~」的なニュアンスで指摘されることが多いらしいです。言われる側も少し楽だし、何より言う側も楽になりますよね。
ただ、例えば自身がリーダーのプロジェクトでお客さん向け資料をメンバーに作ってもらっている、かつ納期がギリギリというときでもこの姿勢を貫けるでしょうか。どうしても、その評価が自分に跳ね返ってくると考えてしまって、自分の思い通りの資料になっていてほしい!と考えてしまい、「これはこう直してください!」という口調になってしまいそうですよね。それか、「もうこれは自分でやった方が良い」となってしまいそう。
本書で推奨されているサーバントリーダーシップと呼ばれるマネジメントでは、メンバーは「結果に対して報いを受ける」とあります。自分の成功は自分の成功だし、逆に失敗は自分の失敗になります。つまり、チーム構成とタスクの割り振りの時点で、そのタスクの責任の所存をそのメンバーに返ってくるようにすべきであり、そうすればおのずと「In my opiniton」的なニュアンスで指摘ができそうだなと思いました。 上記の例では、そのお客さん向け資料作成は自分でやるべきなんだと思います。
そうなると、従来のピラミッド的な構造のチーム割は結構難しいですよね。少人数で入って、それぞれがxxxの専門家です、という感じで担当するのが理想になりそうです。
仕事を楽しんでいるか?を確認する
上記のサーバントリーダーシップと同じくチームビルディングについての話ですが、自己組織チームという方法が近年日本でも取り組まれているらしいです。上司が指示するのではなく、メンバーが自分で考えて意思決定するチームが「自己組織チーム」であるとのこと。そのチームの特徴の一つに「チームのエンゲージメント(満足度)が高い」というものが挙げられています。これに関して、ここに挙げている「仕事を楽しんでいるか?」がとても重要視されるとのことでした。
これは、外資だからか今の会社でも重要視されていますね。そして、自分を含め同年代や周りのメンバーも、仕事を楽しんでいそう。個人的には、技術に関わることを結構な時間できていることが大きいのかもしれません。自分で試しに検証してみたり、色々調べて比較の提案資料を作ってみたりする作業は純粋に楽しいです。あとは、会社の仕組みとしてめっちゃ褒められることもあるのかも。周りからのフィードバックがとにかく多いので、もちろん直すべきところも指摘されますが、それ以上にすごい褒められる。褒められると嬉しいですよね。
おわりに
上記以外にも、色々と参考になることが載っていたので、仕事のやり方とかに迷っている人には結構おすすめです。ただ、個人的には「ノートなどは使わず頭の中だけで試行整理する」「納期は絶対ではない」という2点だけは、余り納得できていないポイントです。ただ、本書で学んだおかげで「こういう意見もあるんだなぁ」というスタンスでいます。このように、すぐに役立つところが多いのも良いところですね。
今回のように、今年は書籍の感想もいくつか書いていきたいですね。大体この記事書くのに1.5時間くらいかかった(読むのは別にして)ので、それくらいは時間使っていきたいと思います!
不偏分散の期待値がσ^2になることを確かめる
皆さんこんばんは。寒い日が続きますね。
ついに明日は統計検定1級を受ける日です。準備は進んでおりますでしょうか。
この前日という日に上げるにはかなり基礎的な内容にはなってしまいますが、不偏分散の期待値の計算、いつもしっくりこなかったんですよね。
それが、かなりクリアになる計算方法をやっと確立できたので記事にします。
不偏分散の期待値計算
そもそも不偏分散とは…という説明はこちらのサイトに譲ります。
bellcurve.jp
簡単に言うと、標本分散と同じような統計値ですが、不偏性を持つようにnで割るのではなく(n-1)で割るようにした分散です。
期待値を取るとσ^2になるのですが、その計算をしていきます(統計検定2018年問1などで出題されたことがあります)。
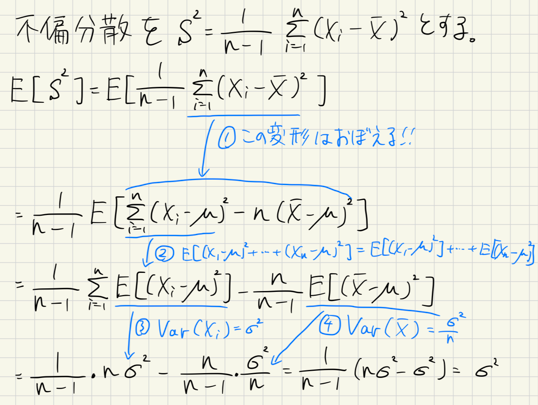
ポイントは青文字で書いた4つです。
ポイント①
身も蓋もないですが、この計算は覚えます。ただ、一度は普通に計算してみても良いかもしれません。
この変形のコツは、最初の二乗式を
このように変形することです。ここから計算していくと、①の変形ができます。
ポイント②
ここは、Σと期待値Eを入れ替えています。式で表すと分かりやすいですよね。
入れ替えて良いかの判断は、一回Σを具体的な値で書き下してみると確認しやすいです。
ポイント③④
これは定義通りです。X_iは、結局確率変数Xに従うため、Var(X)と同じσ^2となります。
Xの平均の分散はσ^2/nとなるのはよく出るので覚えましょう。
おわりに
いろんなサイトにこの計算は載っていましたが、計算するところと覚えるところの良い塩梅が難しく、なかなか自分の中でテンプレ化できないでいましたが、今回、前日になってやっと固まってよかったです。
これで、不偏分散の期待値がどうしても確認したくなった時もばっちり!安心して不偏分散を使いましょう。
確率変数の変数変換を超わかりやすく説明する
まえがき
皆さんは、統計で出てくる確率変数の変数変換をご存じでしょうか。
式を覚えては見たものの、ちょっと応用されると全く分からなくなる、でおなじみの変数変換です。
ならいいんです。ただ、それも範囲を一捻りされると暗記した式では解けなくなります。
私は3年くらい、ずっと悔しい思いをしていましたが、ついに完全理解しました。
なので、その感動を共有すべく、キーボードを手に取った次第です。
変数変換ってどういう問題?
例えばこういう問題です。
(現代数理統計学の基礎 第2章演習問題 問12を一部改変)
ある確率変数Xとその確率密度関数が与えられていて、それをなる関数で変換したときのYの確率密度関数を求めます。
何すればよいか、よくわからないですよね。そんなときのために、公式が用意されています。
変数変換を解く公式
現代数理統計学の基礎 p.24では、以下の公式が記載されています。
確率変数Xの確率密度関数を
とし、
とする。
g(x)が単調増加もしくは単調減少な関数とし、は微分可能であるとする。この時、Yの確率密度関数は次で与えられる。
まずこの式を見ていきます。
まず、という式が2つ出てきます。
これは、の逆関数です。もっと簡単に言うと、
をxについて解いた式です。
例えばであれば、
、つまりは
です。
元の式を見ると、を
に代入したものと、
をyで微分して絶対値を取ったものを掛け合わせています。
先ほどの例、で計算してみると、
となります。あとは、元々のの式を使って計算していけば答えが出ます。
問題は、なぜこのような公式になるのか?ですよね。
公式の導出
現代数理統計学の基礎 p.23に導出が書いてあるので、こちらを補足しながら見ていきます。
全体的な方針としては、以下の2STEPです。
1. 分布関数を式で表す(この時の範囲に注意)
2. を微分して
を示す
1.分布関数 を式で表す
分布関数の定義とから、以下のように書けます。
3番目と4番目は同じことを言っていますが、表記を変えただけです。
4番目の式は、確率変数Xが{ }の中のxである確率という意味です。
さて、このままではxの範囲がyの式のままです。
これをxの範囲に変換します。先ほどの式の{ }の部分だけを見ていくと
と書けます。ここがミソです。
上記の式で、xの範囲がxについて示せました。この範囲の確率Pを積分すれば分布関数になるので、
と表せます。
…私はこの式の変形が何回見てもしっくりきませんでした。
特にこいつ。こいつがいると意味が分からなくなります。
なので、具体的に、先ほどの例で考えます。
この例でxの範囲をyではなくxで表すと
こうなります。なので、この範囲の確率を計算すると
こうなりますね。めっちゃわかりやすい!!
ここから、この分布関数を微分して、本当に求めたかったを求めていきます。
2. を微分して を示す
具体的な方ではなく、一般的な式で見ていきます。
おさらいすると、分布関数は
と表せましたね。これを微分して、インテグラルの中のを取り出します。
この分布関数は定積分です。つまり、の方は定数なので、微分したら消えますね。
そのため、前のの方だけを考えます。
これを微分すると、のxに
を代入したものが出てくる…
だけではなく!
自体を微分したものを掛けます。
なぜそうなるかは、このあたりのHPを参考にしてください。高校数学です。
結局こうなります。
公式の絶対値がついていないバージョンが出てきましたね!
さて、なぜ公式では絶対値がついているのでしょう?
絶対値がついているワケ
公式の中で、この一文に注目して下さい。
g(x)が単調増加もしくは単調減少な関数とし
はい。単調増加、もしくは単調減少です。
先ほどの例で、で考えましたよね。これは単調増加です。
単調減少するで考えてみましょう。
こちらを先ほどのSTEP1と同じように、xの範囲にすると
となります。積分式で書くと
となります。先ほどと積分範囲の∞が逆ですね。
今回のxの範囲は何々以上、なので、xは∞まで値を取ることができますので、このような式になっています。
さて、STEP2の微分をしていきます。
今回は、前の∞は定数になるので微分すると0です。つまり、後ろの方を計算していきます。
その際、定積分の計算をするので、後ろはマイナスがつくことに注意すると、
このように計算できます。
こちら、後ろの微分する項は、-yを微分するのでマイナスが出てきますね。
前についているマイナスと、この微分で出てくるマイナスで結局マイナスが消えてプラスになります。
つまり、g(x)が単調減少の場合は、yの前にマイナスがつきます。
そのため微分すると必ずマイナスが出てきますが、定積分の前後の関係から、そっちでもマイナスが必ず出てきます。
なので結局プラスになるので、単調減少でも公式が適用できるように絶対値がついているんですね。
応用編: の変数変換
ここまでで公式の出し方が分かったと思うので、単純な単調増加、単調減少の関数ではない関数を見ていきます。
現代数理統計学の基礎の演習問題 第2章 問13(3)を解きます。
問題文はここから引用です。
MathStat_Answers.pdf - Google ドライブ
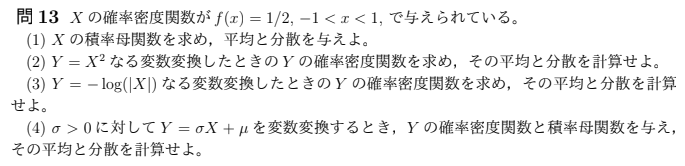
これは単純増加、単純減少ではないので、先ほどの公式がそのまま使えません。
ただ、公式の導出の考え方は使えます。
まずSTEP1でやったことを思い出してください。xの範囲を特定していました。
をxについて解いてみます。
log同士の比較は、底が1より大きければそのまま外せます。今回の底は自然対数eなので1より大きいです。つまり、
となります。
この範囲の積分をすれば、分布関数になるはずです。
今回は範囲がxがある数以下とある数以上に分かれているので、積分は2つ登場します。
これをSTEP2の時と同じく微分します。
ここでであるため、それを代入して計算すると
となります。
また、yの範囲についても計算すると、-1 < x < 1の範囲をで考えて、
となります。
以上で解けましたね。
ポイントは、やはりxの範囲。それを出してからその範囲に従って積分することが重要です。
それが分かれば、どんな変数変換でもできる…はず!
応用編②:xの範囲指定がある の変数変換(2023/4/7追記)
問題を解いていて、もう1点重要な観点に気づきました。
それは、xの範囲でyのグラフが変わるかどうか?です。
現代数理統計学の基礎の演習問題 第2章 問15を解きながら考えます。
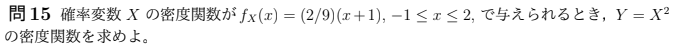
こちらの問題、xの範囲指定がなければ、いつものの変数変換です。
ですが、xの範囲があることで少し事情が変わってきます。
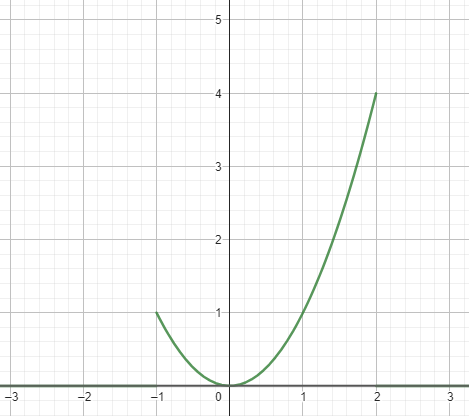
こちらが、今回のxの範囲における、のグラフです。
の範囲、つまり
の範囲においては、通常の
のグラフですよね。
ただ、の範囲においては、第2象限の部分は消えているため、通常の
のグラフとは異なります。
そこで、場合分けが必要になるというわけです。
の場合は、通常の
なので省略。
について考えます。
分布関数を求めると、以下のようになります。
まず1つ目のインテグラルでは、の範囲の積分です。これは定積分になりますね。
2つ目のインテグラルは、xの範囲を考えたときのの兼ね合いで考えます。
xは1より大きいのですから、1より大きく、より小さくなりますね。
後はこれを微分して解いていくだけです。
この問題により、xの範囲でyのグラフが変わる場合の解き方を学ぶことができました。
まとめ
- 変数変換の問題では、分布関数
を積分の形で表してから、微分することで確率密度関数を求める。
- 積分の形で表すとき、xの範囲をyを用いて表すことが重要。
- xの範囲でyのグラフが変わる場合は、yの範囲で場合分けして考える。(2023/4/7 追加)
- 微分するときは、定積分の引かれる側と引く側どちらになるかで、マイナスをつけるかつけないかが変わることに注意。
- 単純増加、単純減少の式であれば公式で解けるが、そうでない変換は公式そのまま使っても解けない。
以上です。
ずっとまとめたいと思っていたので、まとめられてよかったです。
この考え方だと解けない変数変換などあれば、ぜひ教えてほしいので、連絡お願いします。
現代数理統計学の基礎 第2章 問11, 12

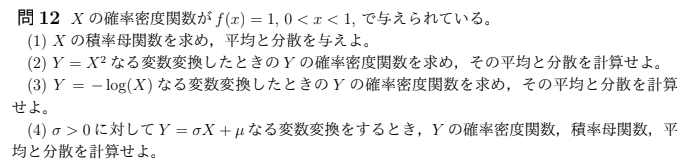
方針(問11)
4つのパートに区切る。
確率関数になることを示す
ここは、以下の2つを満たすことを示せばOK
となること
- 合計が1になること
合計を計算するときは、無限等比級数の和を考える必要がある。
初項をa、公比をrとしたとき、 の時
となる。
それを計算すると1になる。
確率母関数の導出
こちらも無限等比級数の和を計算する。
ただ、またしてもsの範囲が引っかかる。
公比がなので、範囲は
かと思いきや、解答では
になっている。
よくわからないが、sは正の値なのか?ここもわかる方コメント募集。
方針(問12)
(1)
そのまんま計算。分数の割り算に注意して積率母関数を導出する。
平均と分散を考えるときは、ロピタルの定理を使う。意外と計算は短く済む。
あと、なんだからどう見ても平均は1/2だよね、という検算もできる。
(2)
現代数理統計学の基礎のp.25にある、平方変換の変換
を使う。あとは、yの範囲も忘れずに出すこと。
平均と分散については、積率母関数などを使わずに普通に積分で解く。
yの何乗のような形で表せる確率密度関数の平均や分散は、通常の計算方法が一番楽に計算できる。
感想
やっていることは結構パターン化されてきましたね。
変数変換の時の符号、母関数導出の際の範囲、平均分散求めるときの楽な方法などがポイントでしょうか。
このあたりは何度もやって定着させたいところ。
